DevOps для бизнеса: как устроена поставка софта и чем ее измерить

Команда говорит: «не настроен пайплайн», «нужно переезжать в кубер», а со стороны бизнеса видно другое: релиз выходит раз в месяц, после него несколько дней чинят сломанное. И то и другое описывает поставку программного обеспечения, и именно ее налаживает DevOps. WS DEV ведет заказную разработку с 2009 года и слышит обе стороны: команду и заказчика. В статье переведем язык разработчиков на язык денег: как изменение проходит путь от программиста до пользователя, кто должен настраивать этот путь, какие цифры спросить у команды и какие задать самому.
Коротко
- Поставка ПО идет по циклу: задача, код, сборка, тесты, выкладка, эксплуатация, наблюдение. CI/CD автоматизирует середину цикла, от сборки до выкладки.
- Первую настройку конвейера и инфраструктуры лучше доверить специалисту с опытом. У разработчиков она выходит дольше и хуже, потому что их отвлекают на функциональность.
- У команды стоит спросить четыре метрики: срок поставки изменения, частоту развертываний, долю неудачных изменений и время восстановления.
- RPO и RTO задает бизнес: сколько данных компания готова потерять при сбое и сколько готова ждать восстановления. Инженеры подбирают под эти цифры решение.
- Разбираться с поставкой пора, когда выкладку боятся делать в пятницу, после релизов откатываются, а инфраструктуру знает один человек.
Как выпускали софт до DevOps
До DevOps софт в большинстве компаний выпускали поэтапно. Программисты дописывали функциональность и отдавали сборку тестировщикам. Тестировщики находили ошибки и возвращали ее обратно. Когда сборка наконец проходила проверку, ее забирали администраторы и по инструкции вручную переносили на серверы, часто ночью.
Каждое изменение проходило этот путь заново, снова и снова. Разработка и эксплуатация сидели в разных отделах, с разными руководителями и разными целями. Разработчиков оценивали по новым функциям, администраторов по тому, как редко падают серверы. Когда после выкладки что-то ломалось, разговор часто сводился к взаимным обвинениям: «у нас все работает, это у вас окружение настроено неправильно».
Выкладка стоила дорого: ночь работы администраторов, риск простоя и долгий разбор, если что-то пойдет не так. Поэтому жалобы пользователей и пожелания бизнеса ждали, пока их наберется достаточно для осмысленного релиза. Но вместе с изменениями накапливались и потенциальные точки отказа. Релизы проходили болезненно, паттерн укреплялся.
У разработчиков есть присказка: пятничный релиз ведет к рабочим выходным. Редкие большие релизы и выходные на починку оставались нормой, пока разработка и эксплуатация не договорились работать вместе.
До DevOps изменение идет по цепочке отделов: код, проверка, ручной перенос на серверы
Методология или должность: откуда взялся DevOps-инженер
DevOps начинался как договоренность разработки и эксплуатации отвечать за поставку вместе, а роли и должности выросли из этой договоренности позже. История укладывается в несколько дат.
В 2001 году авторы манифеста Agile предложили выпускать рабочие версии короткими итерациями, и разработка ускорилась. Эксплуатация осталась прежней: новые версии появлялись чаще, а на серверы попадали по старому графику. Разрыв между отделами стал заметнее.
В июне 2009 года Джон Олспоу и Пол Хэммонд из Flickr выступили с докладом 10+ Deploys Per Day: Dev and Ops Cooperation, где рассказали, как добились больше десяти выкладок в день, потому что разработчики и администраторы работали как одна команда. В октябре того же года в Бельгии прошла первая конференция devopsdays, так окончательно закрепился термин DevOps. Подход продолжил идеи бережливого производства и гибких методологий: выпускать маленькими частями и быстро узнавать, что сломалось.
Должность DevOps-инженера появилась позже, когда компаниям понадобились люди, которые строят инструменты для общей работы. Сама ответственность за доставку осталась общей для всей команды.
DevOps и SRE: кто есть кто
DevOps задает философию, SRE (Site Reliability Engineering, инженерия надежности) воплощает ее конкретными правилами и цифрами. Названия ролей вокруг DevOps часто смешивают. Коротко о каждой:
- системный администратор отвечает за серверы, сеть и доступы в рабочем состоянии и чаще всего работает по заявкам;
- DevOps-инженер строит конвейер (также говорят пайплайн) поставки и описывает инфраструктуру кодом, чтобы выкладка шла без ручной работы;
- SRE отвечает за надежность в цифрах: задает цели доступности и оценивает, чем релиз грозит стабильности;
- DevSecOps встраивает проверки безопасности в тот же конвейер, рядом со сборкой и тестами;
- платформенная команда собирает внутреннюю платформу: готовые шаблоны конвейера, окружений и мониторинга для остальных команд.
Когда команда говорит, что ей нужен DevOps, полезно уточнить, о чем речь: о человеке, который настроит конвейер, или о том, как вся команда будет выпускать изменения и чинить сбои. Ответы на эти два вопроса разные, и бюджет под них тоже разный.
Кто настраивает DevOps: разработчики сами или специалист
Первую настройку конвейера и инфраструктуры лучше делает специалист, который уже собирал такое на других проектах, но ответственность за корректность работы ложится на всю команду — если какой-то элемент конвейера ломается, то может нарушиться весь процесс.
Разработчики могут собрать конвейер сами, и на небольших проектах так часто и делают. По нашему опыту, на средних и больших проектах выходит дольше и хуже по понятной причине: нельзя быть экспертом во всем. Настройка сборки, окружений, бэкапов и мониторинга требует своего времени, а разработчиков в это же время торопят с функциями.
Работа эта заметная даже в цифрах. По оценке IDC за 2024 год, на саму разработку приложений у разработчиков уходит 16% времени. Внедрение CI/CD, развертывание кода и мониторинг производительности приложений занимают по 12%, мониторинг инфраструктуры еще 11% — в сумме это почти половина всего рабочего времени. Бизнес эти часы обычно не видит, и выгода от настроенного конвейера тоже может остаться незамеченной, потому что улучшения происходят постепенно, а не вследствие одного яркого события.
Типичная картина в компании, где настраивают сами: конвейер собирали между задачами, по частям, и он остался в том виде, в каком его успели собрать; разработчики по очереди подступались к серверам; бэкапы формально есть. Восстановить из них систему никто ни разу не пробовал. Пока ничего не сломалось, схема выглядит рабочей.
После запуска специалист нужен реже. Конвейер работает, пока команда пользуется им каждый день: пишет тесты к новым функциям, не обходит проверки в срочных случаях, обновляет описание инфраструктуры вместе с кодом. Если после настройки то и дело возвращаются к привычным методам, «в последний раз, в порядке исключения», конвейер быстро устареет. Запуск силами специалиста требует последующей дисциплины всей команды.
Своих сил хватает, пока проект небольшой: один сервер, релизы раз в несколько недель, час простоя никому не вредит. Отдельный специалист нужен, когда:
- выкладка регулярно падает, а восстановление занимает часы;
- разработчики застревают на конвейере вместо функций;
- появились требования регулятора к данным и доступам;
- команда выросла, и ручная выкладка тормозит всех.
Инженер в штат стоит заметных денег. По данным отчета State of DevOps Russia 2025 (здесь и далее данные из него, если не указан другой источник), медиана предлагаемой зарплаты DevOps-специалиста в 2024 году составила 231 тыс. ₽ в месяц. Несколько лет таких специалистов не хватало: в 2019–2021 годах вакансии DevOps на hh.ru росли на 59% в год, резюме примерно на 23%, и сам hh.ru назвал это дефицитом. В первом полугодии 2025 года вакансий стало на 26% меньше, чем годом раньше, и разрыв между вакансиями и резюме сократился до 18%.
Можно заключить так: преждевременный наем ударит по бюджету, но запоздалый ударит еще сильнее. Поймать подходящий момент помогут три вопроса: насколько сложна инфраструктура, сколько стоит час простоя и есть ли в команде человек, который уже настраивал такое.
Практики вокруг цикла поставки: код, инфраструктура, сборка и выкладка, наблюдение
Как устроен конвейер поставки: CI/CD по этапам
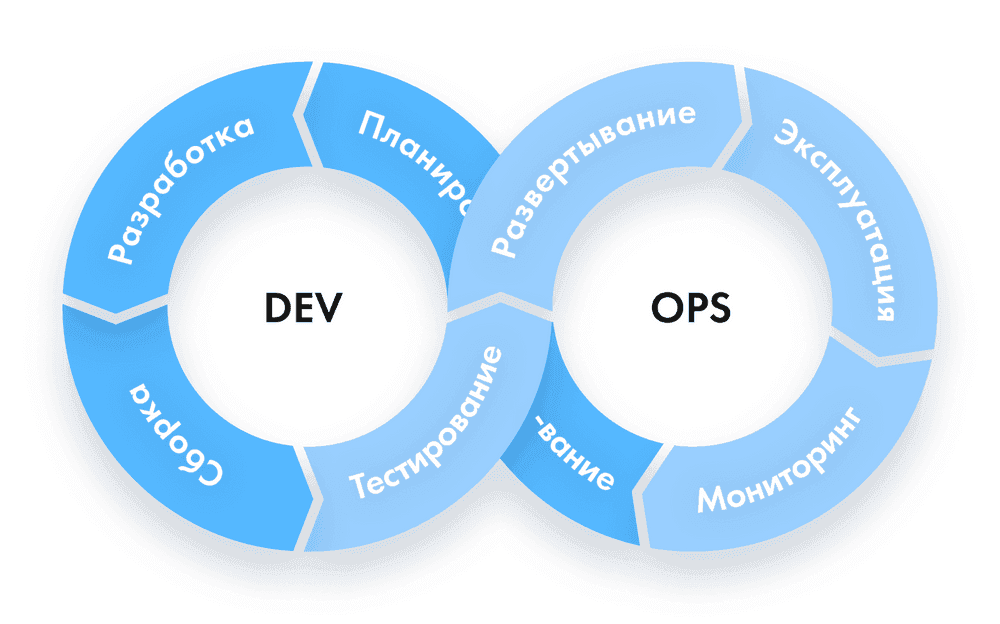
Конвейер поставки проводит каждое изменение по одной и той же петле: план, код, сборка, тесты, выкладка, эксплуатация, наблюдение и обратная связь, которая снова становится планом. Автоматическую часть петли, от сборки до выкладки, называют CI/CD. В российских командах конвейер чаще всего строят на GitLab CI/CD: им пользуются 64,5% респондентов. Совсем без CI/CD работают 7,6%, годом раньше таких было 13,3%. Написанный код запускают минимум в двух местах. К каждому этапу у бизнеса есть свой вопрос к команде:
Окружения и контейнеры
На стейджинге новую версию проверяют команда и заказчик. В рабочей среде, продакшне, работает версия, которой пользуются клиенты.
Между локальным окружением разработчика, то есть его компьютером, и стейджингом, удаленным сервером, есть отличия: другая версия языка, подключенных библиотек и настроек операционной системы. Из-за этого при переносе проект часто не собирался. Для решения этой проблемы придумали контейнеризацию. Контейнер упаковывает приложение вместе с окружением, и сборка ведет себя одинаково на ноутбуке программиста, на тестовой площадке и на рабочем сервере. Самый распространенный инструмент для контейнеров — Docker.
WS DEV работает с 2009 года. По мере роста к 2014 году мы пришли к разработке в Git на нескольких окружениях. С тех пор процесс улучшали, а схема выкладки по-прежнему укладывается в три площадки. Продакшн работает на ветке master. Демо-стенд повторяет рабочую среду, его база синхронизируется с ней раз в сутки. Дев-стенд проверяет новый функционал с соответствующей ветки репозитория. Инструменты за эти годы полностью сменились, принцип остался: у каждого изменения есть место, где его проверяют до клиентов.
Помимо продуктивной площадки для конечных пользователей необходимы еще как минимум две: для разработчиков и тестеровщиков.
Интеграция, доставка, развертывание: три ступени CI/CD
За аббревиатурой CI/CD стоят три ступени автоматизации, и команды останавливаются на разных:
Развертывание без человека на последнем шаге требует хороших автотестов и наблюдаемости. Многие команды поэтому останавливаются на доставке, и релиз все равно проходит по кнопке.
Выкладка без простоя и откат
После автотестов сборку переносят в рабочую среду так, чтобы пользователи не заметили перерыва. Это называют выкладкой без простоя, или даунтайма, и у нее два распространенных способа:
- Канареечный релиз: новую версию открывают небольшой группе пользователей, смотрят на ошибки и отзывы и только потом включают для остальных.
- Blue-green: новую версию разворачивают на соседних серверах, проверяют и переключают туда весь трафик. Старая версия стоит рядом, пока новая не покажет, что работает.
Оба способа нужны ради отката. Если после релиза растут ошибки, трафик возвращают на прежнюю версию. Сложнее всего с базой данных: миграции пишут так, чтобы с новой структурой базы работали обе версии приложения. Вопрос к команде простой: сколько минут занимает откат и когда его последний раз делали.
Наблюдаемость: логи, метрики, трассировка
Работа конвейера не заканчивается на релизе. После выкладки команда должна видеть, как система ведет себя у пользователей. Наблюдаемость складывается из трех источников данных:
- Логирование: записи о событиях внутри приложения, например что пользователь положил товар в корзину. Логи со всех серверов собирают в одно хранилище, часто на ELK: Elasticsearch хранит записи и ищет по ним, Kibana показывает результаты.
- Метрики: числа о состоянии системы, например время ответа, нагрузка, доля ошибок. Prometheus регулярно опрашивает серверы и сохраняет значения, Grafana строит по ним панели и рассылает оповещения. Логи Grafana тоже показывает, через Loki и похожие хранилища.
- Трассировка: путь одного запроса через все сервисы системы. По ней видно, на каком шаге запрос застрял. Для трассировки используют, например, Jaeger.
Мониторинг на этих данных отвечает на вопрос, работает ли система прямо сейчас. Grafana стоит у 74,1% российских респондентов, Prometheus у 58,5%.
Наблюдаемость проверяется одним вопросом: можно ли за пять минут понять, что упало и почему. Если для ответа нужно зайти на три сервера и позвонить человеку, который все настраивал, наблюдаемости нет.
Инфраструктура как код и облака
Кто размещал сайт на хостинге, помнит, как это устроено. Провайдер по тарифу выдает серверные мощности, а рычагов управления почти нет: чтобы что-то поменять, приходится писать в поддержку или менять тариф. Настройкой такого сервера обычно занимался системный администратор.
Облако дало команде больше рычагов. В модели IaaS компания арендует виртуальные серверы, диски и сети и сама выбирает объем хранилища, тип дисков и число ядер процессора. Мощности добавляют при росте нагрузки и убирают, когда она спадает. В модели PaaS платформа берет на себя еще и запуск приложения: команда выкладывает код и задает параметры, серверы обслуживает провайдер. Контроля при этом меньше, и при большой нагрузке PaaS может выйти дороже.
Чем плотнее система завязана на сервисы одного облака, тем дороже потом переезд. Это реальный риск привязки к поставщику, и снижают его заранее: открытыми инструментами и описанием инфраструктуры, которое можно развернуть на другой площадке.
Инфраструктура как код, IaC, означает, что серверы, сети и настройки описаны в файлах и лежат в репозитории рядом с кодом приложения. Окружение тогда можно воспроизвести с нуля, изменения видны в истории, а новый сервер собирается по описанию, без ручной настройки по памяти. Один из самых известных инструментов — Terraform: его используют 36,1% респондентов, Ansible 59,6%, а 10,2% до сих пор управляют инфраструктурой вручную.
Когда контейнеров становится много, ими управляет оркестратор, чаще всего Kubernetes. Проект открыли в 2014 году, сегодня это стандарт для крупных систем. Небольшому проекту Kubernetes, как правило, не нужен: настройка и сопровождение кластера стоят дороже пары обычных серверов.
Облако в российских командах не единственный вариант. По тому же отчету, 34% респондентов держат системы на своей инфраструктуре, 29% используют гибридную схему, 11% работают в одном облаке. На выбор влияет и закон: по ч. 5 ст. 18 152-ФЗ первичная база с персональными данными россиян должна находиться в России. При переезде в облако первым делом смотрят, где физически окажутся данные клиентов. Тот же вопрос встает при импортозамещении, когда систему переносят на российские облака и операционные системы.
Систему, описанную в репозитории, переносить проще: описание разворачивают на новой площадке и сверяют результат со старой. Но часто знания об инфраструктуре находятся в головах отдельных сотрудников, поэтому переезд начинается с раскопок.
Метрики DORA: что спросить у команды
Чтобы оценить качество DevOps, принято опираться на метрики DORA. Их ведет исследовательская программа DORA (DevOps Research and Assessment), которая сейчас входит в Google Cloud. Эти метрики показывают, как быстро и насколько надежно команда доставляет изменения пользователям. Считать эти цифры имеет смысл там, где программные решения так или иначе приносят доход.
Метрик пять, они делятся на две группы. Первые три показывают пропускную способность, последние две — стабильность:
- срок поставки изменения: время от коммита до рабочей среды;
- частота развертываний: как часто команда выкладывает изменения;
- время восстановления после неудачного развертывания, раньше его называли MTTR;
- доля неудачных изменений: какая часть выкладок требует срочного вмешательства;
- доля внеплановых развертываний, которые пришлось сделать из-за инцидента в рабочей среде.
Старое наблюдение про дефекты, найденные поздно, в этих метриках становится измеримым. Доля неудачных изменений показывает, как часто ошибка доходит до пользователей, время восстановления показывает, сколько она существует.
Бенчмарк по метрикам в отчете 2024 года разделил команды на четыре уровня:
У команд среднего уровня неудачных изменений меньше, чем у высокого: они выкладывают реже, зато стабильнее. Авторы отчета 2024 года считают лучшими те команды, которые улучшаются от замера к замеру.
В отчете 2025 года DORA отказалась от четырех уровней и описала семь профилей команд. Метрики поставки, по словам авторов, показывают, что происходит, но не объясняют почему. Цифры дают повод для разговора с командой, причину находят в самом разговоре.
Российские команды распределились так: превосходный уровень 23%, высокий 41%, средний 24%, низкий 12%. В 2024 году доли были 19, 39, 33 и 9%. Пороги у российского исследования свои, и по частоте развертываний российские группы ниже, поэтому отчеты напрямую не сравнивают.
Что спросить у команды:
- Сколько времени проходит от готового изменения до пользователей?
- Как часто мы выкладываем и сколько людей участвует в релизе?
- Какая доля релизов за последний квартал потребовала срочного исправления или отката?
- Сколько заняло восстановление после последнего сбоя?
Первый замер нужен, чтобы видеть тренд. Через квартал те же четыре вопроса покажут, становится ли поставка быстрее и спокойнее.
RPO, RTO и SLO: какие цифры задает бизнес
RPO и RTO описывают, сколько данных бизнес готов потерять при сбое и сколько времени система может восстанавливаться.
RPO (Recovery Point Objective, целевая точка восстановления) — момент до сбоя, к которому данные можно вернуть из последней резервной копии. Если копию делают раз в сутки, сбой вечером стоит дня работы с данными.
RTO (Recovery Time Objective, целевое время восстановления) — сколько система может пробыть в восстановлении, пока это не ударило по процессам бизнеса. RTO всегда короче допустимого простоя самого процесса: если склад может отгружать товар по бумажным накладным до вечера, система должна заработать раньше.
Эти цифры задают руководство и владельцы процессов, а инженеры подбирают под них решение. Так это описывает руководство NIST SP 800-34: цели восстановления определяют в анализе влияния на бизнес. Там же предлагают искать баланс. Чем дольше простой, тем дороже он обходится. Чем короче RTO, тем дороже решение: немедленное восстановление требует зеркалирования и резервной площадки, а длинное RTO закрывается обычным резервным копированием.
Цифра RPO зависит от бэкапов. Например, есть правило 3-2-1: три копии данных, на носителях двух разных типов, одна копия вне площадки. Восстановление проверяют по расписанию, а порядок действий при крупной аварии записывают в план аварийного восстановления, DRP.
Вторая группа цифр описывает доступность. SLA, SLO и SLI часто путают, хотя различаются они последствиями:
Если последствий нет, договоренность остается SLO, даже когда документ называется SLA. Так разводит эти понятия Google SRE Book. Там же объясняют, почему 100% доступности не ставят целью: она недостижима и пользователям не нужна. Команда вместо нее получает бюджет ошибок, то есть допустимый простой, который можно потратить на релизы и эксперименты.
Проценты удобнее читать в часах. Доступность 99,9% за год означает 8,76 часа простоя, за 30 дней 43,2 минуты. При 99,99% за год набегает 52,6 минуты. Каждая следующая девятка требует резервов и дежурств, поэтому ее задают под реальную цену простоя.
Российские команды следят за этим чаще, чем за другими показателями безопасности: время восстановления после инцидента отслеживают 39,6% респондентов, это самая частая метрика информационной безопасности в отчете.
Что записать в договор с командой или подрядчиком поддержки:
- целевые RPO и RTO для главных процессов;
- SLO по доступности и способ его измерения;
- время реакции и время решения для каждой линии поддержки, с первой по третью;
- как часто проверяют восстановление из бэкапа и кто получает отчет.
Если этих цифр нет ни в одном документе, их стоит назначить до следующего сбоя. После сбоя договориться о них труднее.
Что меняется с ИИ
ИИ меняет DevOps с двух сторон: ускоряет работу команды и сам становится системой, которую нужно эксплуатировать.
По отчету DORA 2025, ИИ в работе используют 90% специалистов, и больше 80% считают, что он повысил их продуктивность. При этом 30% мало или совсем не доверяют сгенерированному коду. Отчет связывает ИИ с ростом пропускной способности и одновременно с ростом нестабильности поставки. Код пишется быстрее, изменений в конвейер приходит больше, и автотесты, откат и наблюдаемость нужны сильнее, чем до ИИ.
В России ML- и AI-решения используют 71,3% респондентов State of DevOps Russia 2025. Главной сложностью внедрения называют конфиденциальность данных.
Вторая сторона касается самих моделей. Когда компания запускает языковую модель внутри своего контура, у DevOps появляются знакомые задачи на новом объекте: единая точка доступа для всех сервисов, учет потребления по сотрудникам и отделам, мониторинг, который замечает деградацию ответов модели раньше пользователей. Для персональных данных периметр важен отдельно: по 152-ФЗ их первичная база должна оставаться в России.
Компании обычно приходят к моделям одним из четырех путей:
- сотрудники пользуются публичными сервисами без всяких правил;
- компания запретила ИИ целиком;
- отдел строит свою модель сам, без общей инфраструктуры;
- данные отдают в публичное облако с моделями.
В каждом случае вопрос один: где проходят данные и кто видит, как работает модель. Ответ на него дает тот же набор практик: конвейер, описание инфраструктуры кодом и наблюдаемость.
Признаки, что поставку пора приводить в порядок
Поставку пора разбирать, когда ее состояние начинает влиять на бизнес. Обычно это видно по нескольким ситуациям:
- выкладку делают вручную, и в пятницу не выкладывают вообще;
- после релизов регулярно откатываются или чинят сломанное в срочном порядке;
- время восстановления после сбоя никто не замерял;
- инфраструктуру знает один человек, и его отпуск планируют вокруг релизов;
- бэкап есть, но восстановление из него ни разу не проверяли;
- сайт падает в час пика, а подрядчик не объясняет причины аварий и держит доступы у себя;
- документации на инфраструктуру нет, и новый инженер разбирает систему как черный ящик.
Двух-трех совпадений достаточно, чтобы посчитать для своей системы RTO и метрики DORA. Цифры покажут, с чего начинать.
Команда WS DEV предоставляет услуги в области DevOps — настраиваем инфраструктуру под ключ, проведем аудит существующей инфраструктуры, подключимся в формате поддержки или предоставим выделенного инженера в вашу команду.
С чего начать разговор с командой
Разговор о DevOps сводится к поставке: как изменение доходит от программиста до клиента и что происходит, когда по дороге что-то ломается. Первую настройку этой дороги разумно доверить человеку с опытом, держать ее будет вся команда. Проверить результат помогают две группы цифр: метрики DORA спрашивают у команды, RPO, RTO и SLO бизнес задает сам.
Практическая тонкость: разговор с командой удобно начинать с последнего сбоя. Сколько он длился, сколько данных потеряли, кто узнал первым и сколько занял откат. Четыре ответа про конкретный случай скажут о поставке больше, чем общий вопрос «у нас все нормально?».